Trabalho de Conclusão de Curso, IFPR Campus Palmas
Toda resposta mostra de onde veio.
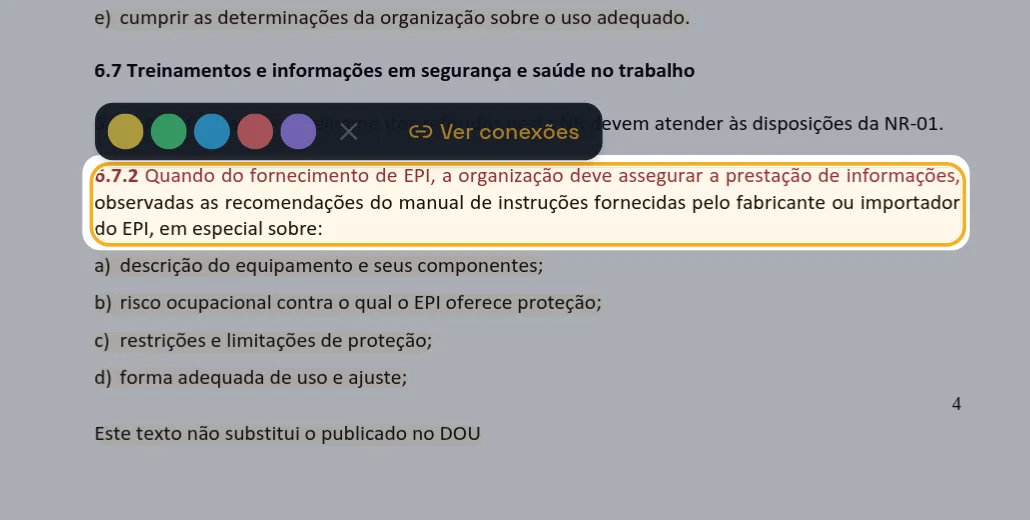
O ThingIndex responde perguntas sobre coleções de PDFs e abre cada fonte: o documento, a página e o parágrafo destacado.
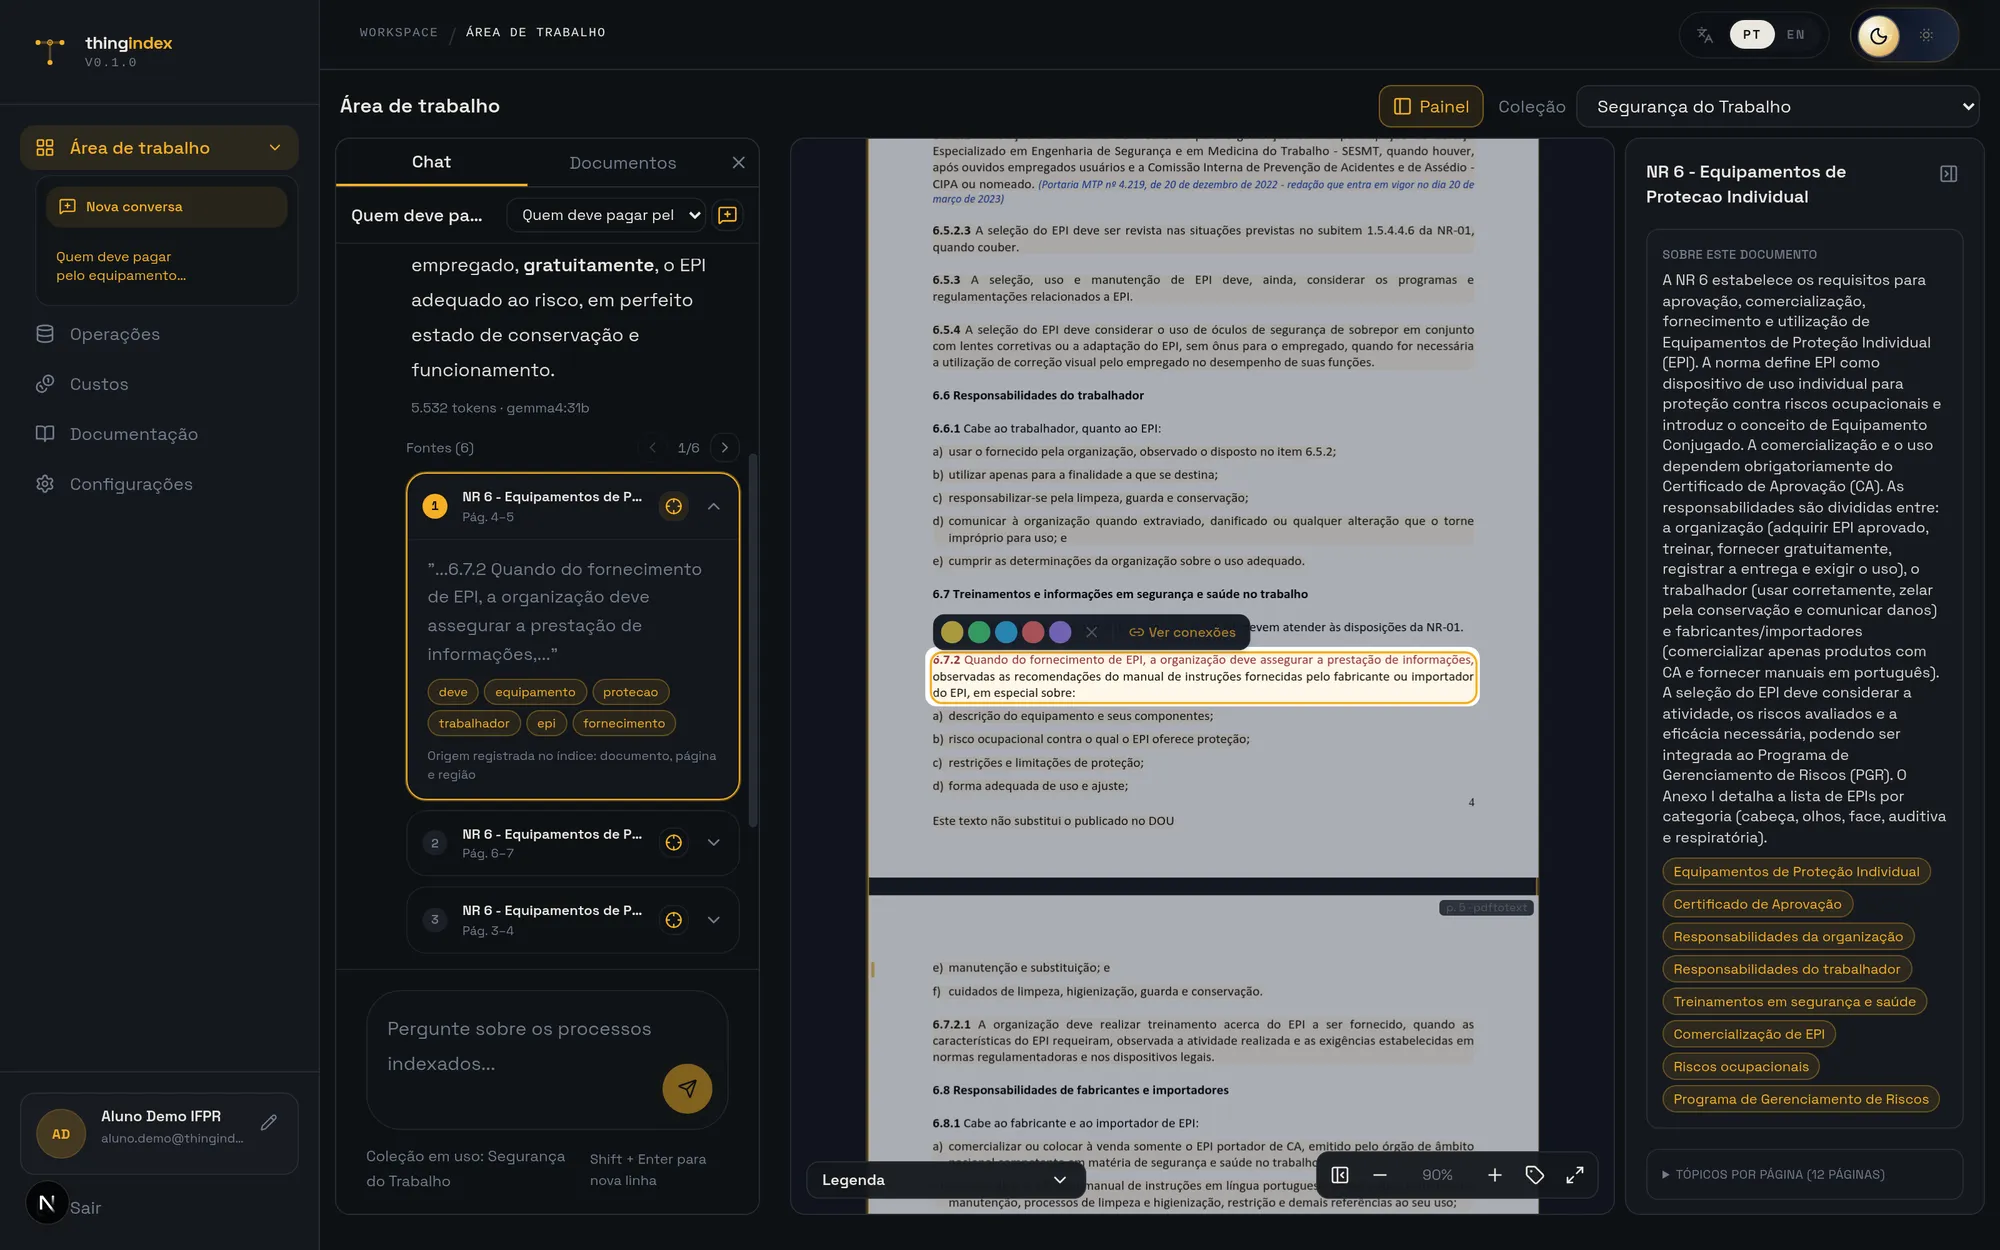
Fig. 1. Workspace de uma coleção de normas de segurança do trabalho.
1A fonte numerada no chat, com o documento e a página.
2O PDF aberto na página citada, com o parágrafo destacado.
Pergunta de pesquisa
“É possível sustentar um sistema de inteligência documental com auditabilidade utilizando exclusivamente modelagem relacional, sem depender de bancos vetoriais ou grafos como camada primária de recuperação?”
A ideia
- 1
Cada parte do documento (página, parágrafo, linha de tabela, seção do sumário) é uma linha de tabela no PostgreSQL, ligada ao documento por chave estrangeira e com a página de origem.
- 2
A busca é por palavras, com BM25, sem banco vetorial.
- 3
Na pergunta, o LLM só entra no fim, para redigir a resposta a partir das fontes que a busca escolheu.
Por isso a página mostrada ao usuário vem do banco, e não do texto escrito pelo modelo.
Da pergunta ao parágrafo destacado.
Pergunta
do usuário, sobre uma coleção de PDFs
Usuário
Busca BM25
nas tabelas da coleção
PostgreSQL
Até 9 fontes
documento e página lidos do banco
PostgreSQL
O LLM redige
a resposta, só a partir das fontes
Modelo
A tela abre a fonte
no PDF, com o parágrafo destacado
Tela
O modelo não escolhe as fontes: elas vêm da busca e do banco antes de ele escrever.
Na configuração padrão, ele só influencia a busca pelos resumos que gerou na indexação. No envio, a API grava o documento e o pedido de indexação na mesma transação (outbox), e o indexer extrai páginas, parágrafos com posição, tabelas e sumário. Um teste de caos derruba a fila, o banco e o armazenamento com o sistema em uso e confere que ele volta sozinho.
- Frontend
- Next.js 16 e React 19
- API e indexer
- Go, com Gin e GORM
- Banco
- PostgreSQL 16
- Fila
- RabbitMQ
- Arquivos
- compatível com S3 (MinIO no local)
- LLM
- configurável (os experimentos usaram Ollama)
O que os números dizem, com as ressalvas.
O ThingIndex foi avaliado em sete acervos em português: seis de PDFs públicos reais (documentos do IFPR, leis, Normas Regulamentadoras, manuais e um edital) e um de controle, com cerca de 870 páginas no total. As hipóteses foram registradas antes de medir, os gabaritos ficam travados por hash e toda correção feita depois da medição está no Anexo A8.
- Busca por palavras ou por significado: qual acha mais?
- Ficaram próximas: 13 de 16 contra 11 de 16 consultas, sem diferença detectável
- Buscar trechos custa menos que mandar o PDF inteiro ao modelo?
- Sim, no acervo de desenvolvimento: na mediana das perguntas com resposta, cerca de 9 vezes menos tokens, com 71 de 72 perguntas certas nos dois casos (configurações diferentes entre os dois)
- Quanto o sistema acerta em perguntas novas?
- 68,1% das respostas, cerca de 7 em 10; 55,4% das respostas com página-alvo estavam certas e com a página certa entre as fontes
- A redação da pergunta muda o acerto?
- Sim: 88,2% com as palavras do documento e 38,7% com outras palavras
- Expandir a pergunta com um LLM ajuda?
- De 68,1% para 88,7% (experimental, desligada por padrão)
- Fonte certa garante resposta certa?
- Não: o sistema citou, com a página certa, o artigo de uma lei revogada.
- Perguntado se a modalidade “tomada de preços” existe, respondeu que sim e citou corretamente o art. 22 da Lei 8.666, sem dizer que ele foi revogado. Quem confere a fonte encontra o artigo na página indicada, sem nada que avise que ele já não vale.
As ressalvas de cada número e a resposta à pergunta de pesquisa, condição por condição, estão nas Seções 8 e 9 do artigo.
O sistema em telas.
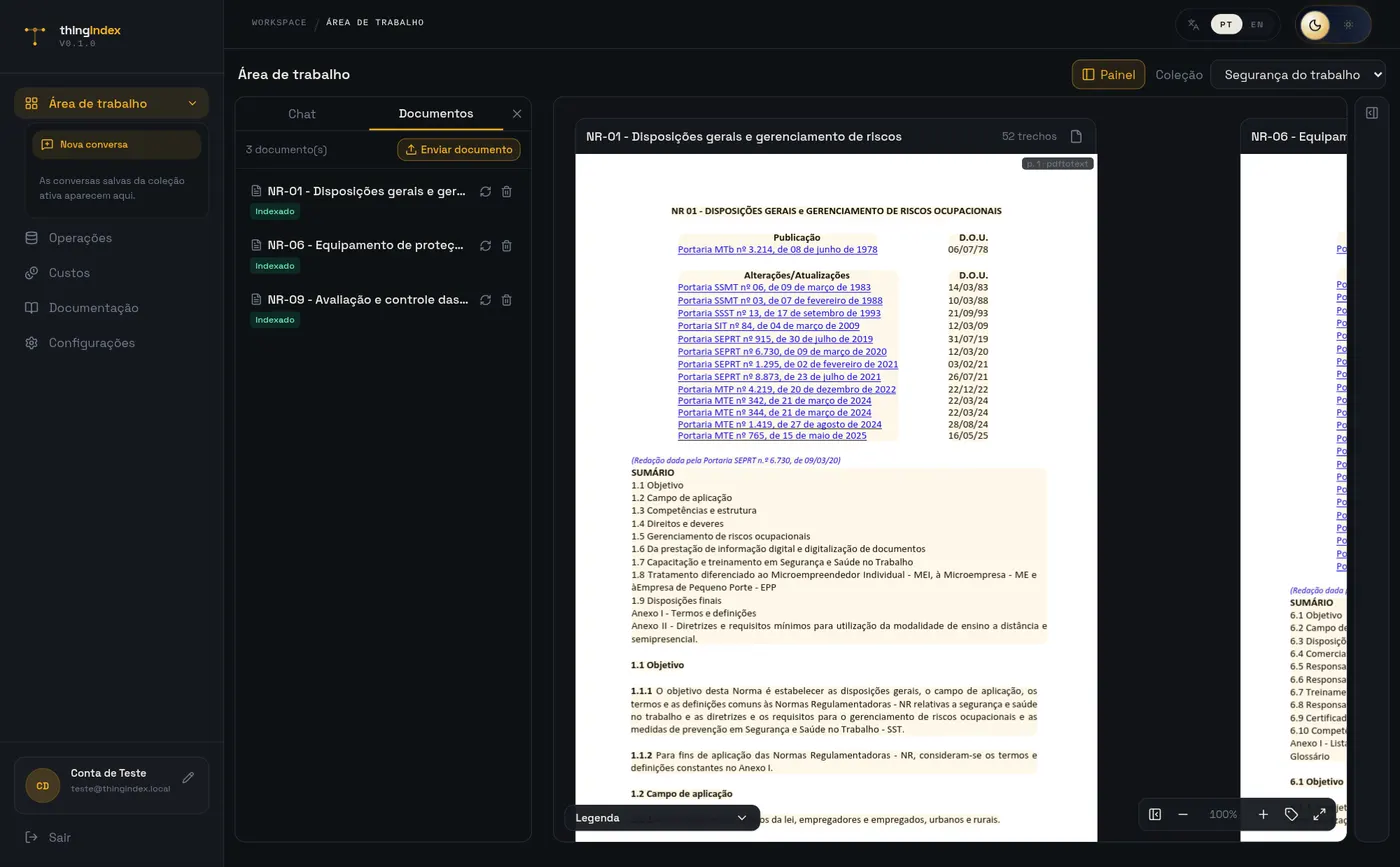
Fig. 3. Área de trabalho. Documentos indexados da coleção. 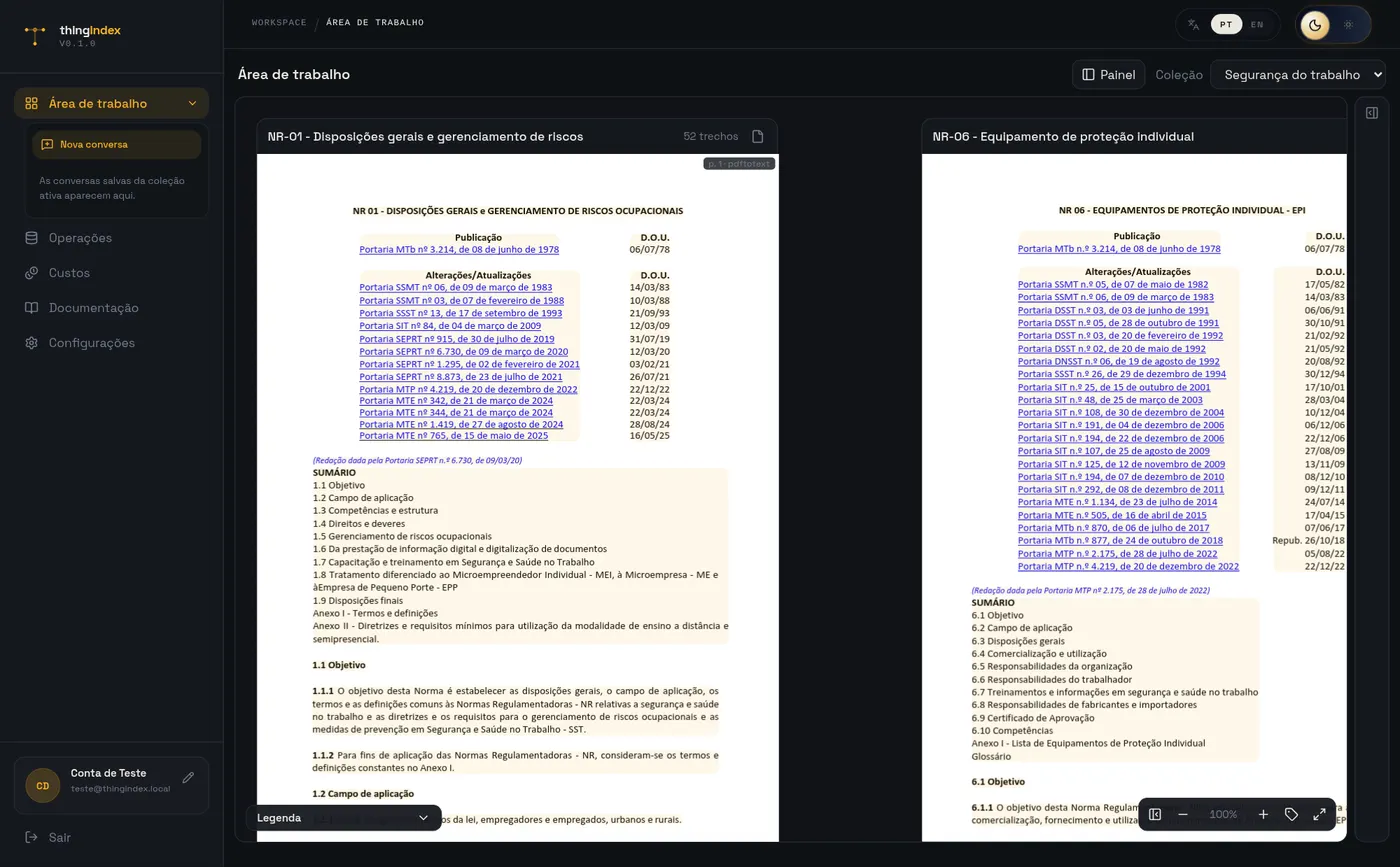
Fig. 4. Leitura. PDFs da coleção abertos lado a lado. 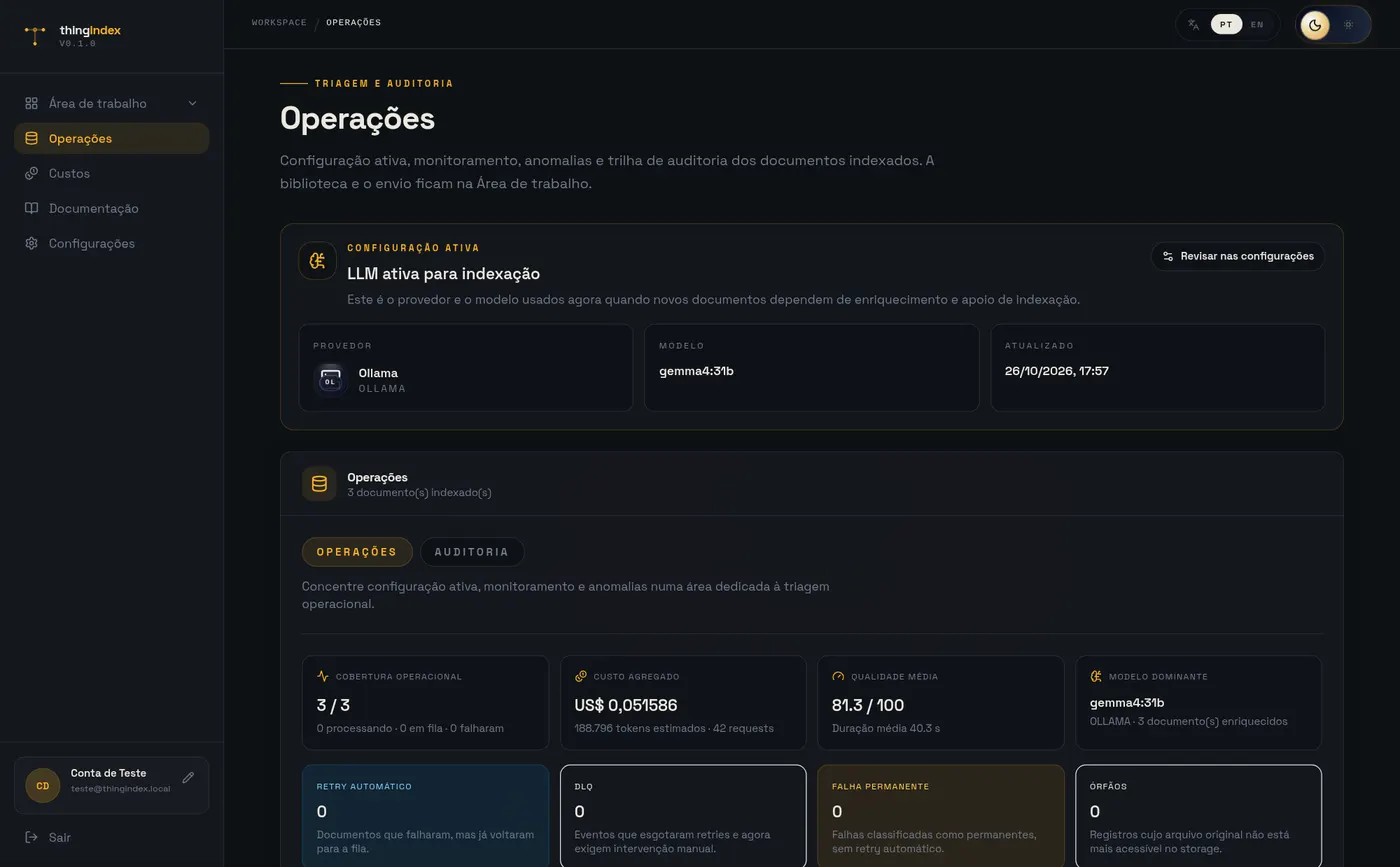
Fig. 5. Operações. Andamento da indexação. 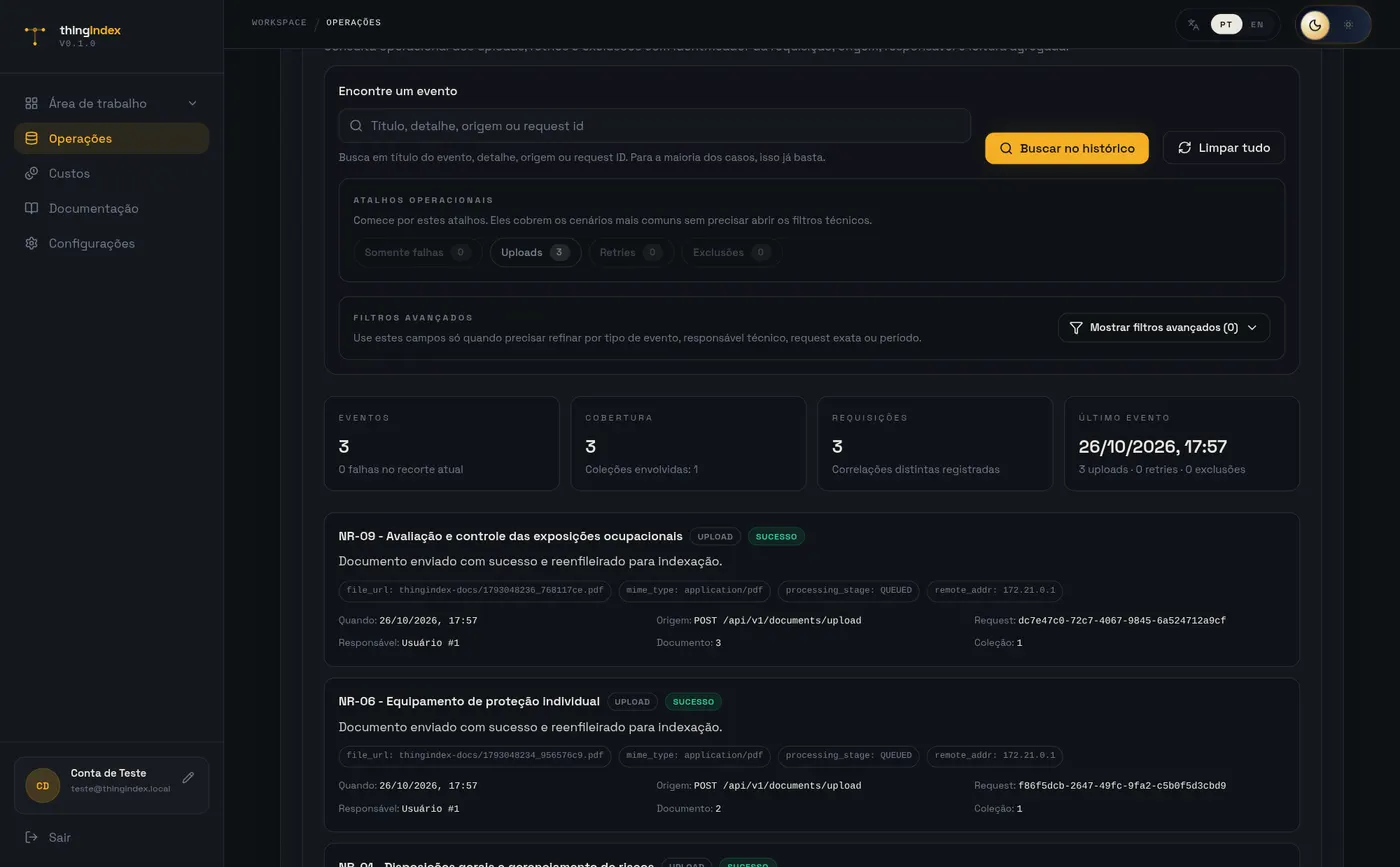
Fig. 6. Auditoria. Trilha de eventos dos documentos. 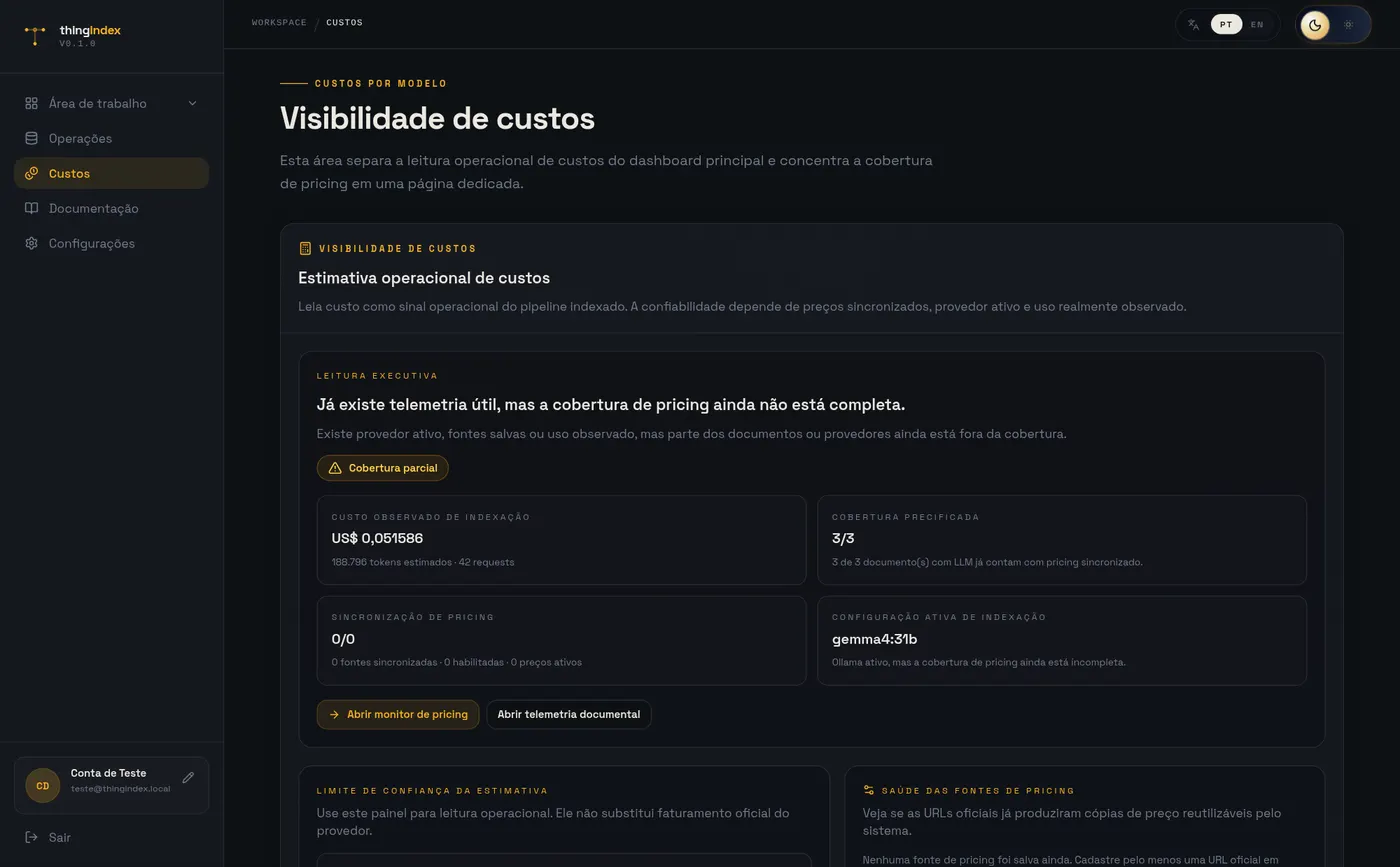
Fig. 7. Custos. Consumo de tokens e custo estimado. 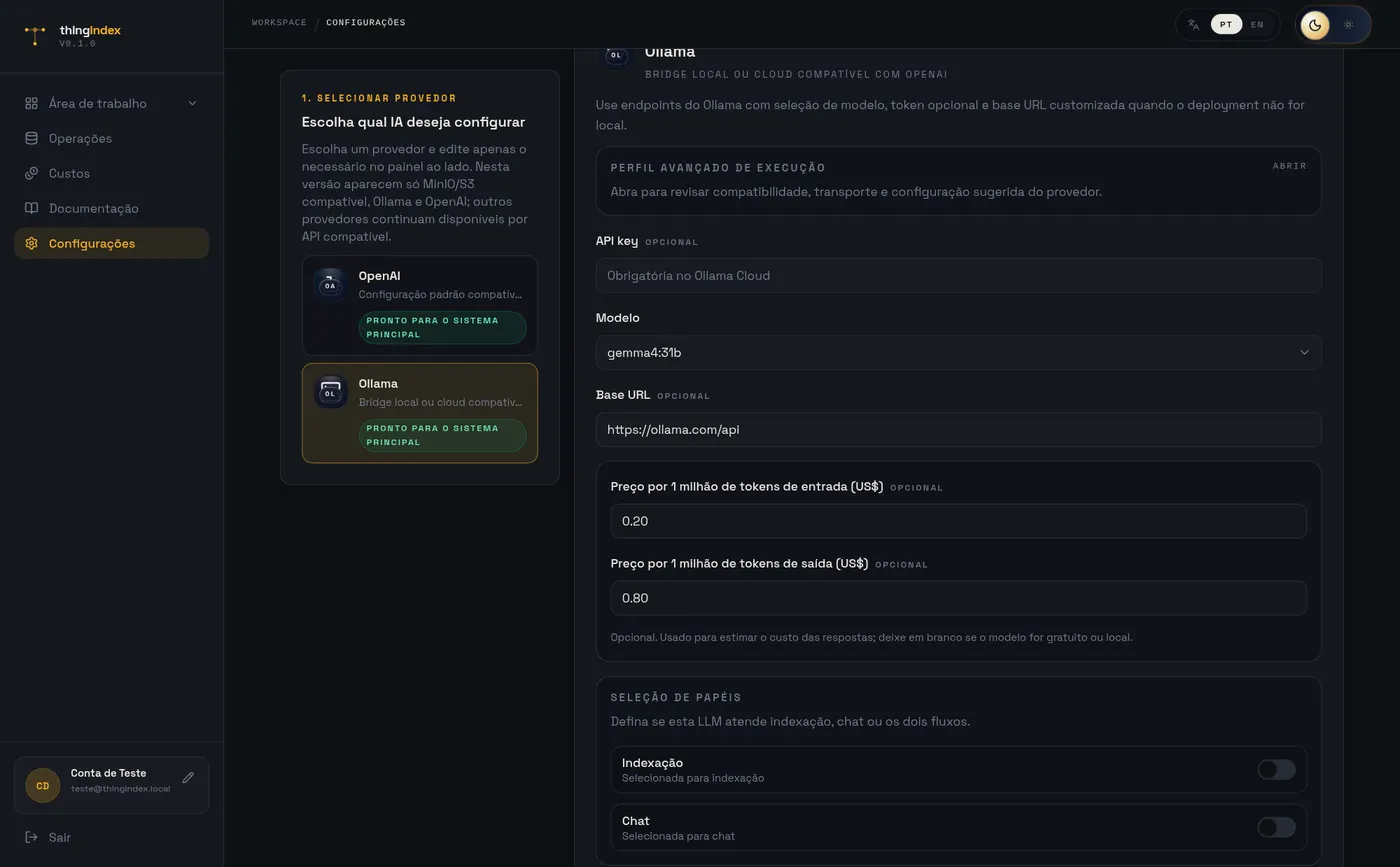
Fig. 8. Provedores. Modelo, URL e preço por milhão de tokens.
*Versão do TCC · em evolução
O que esta versão ainda não faz, e o que vem depois.
O que está nesta página é a versão que entreguei como TCC em 2026. Já tenho uma lista longa de melhorias e vou trabalhar nelas conforme o tempo permitir. Os limites abaixo são os que o próprio artigo mediu, e os trabalhos futuros seguem a ordem que propus nele.
Limites medidos
- Não é adequada a acervos que misturam normas vigentes e revogadas: foi daí que veio o erro mais grave.
- Não atende a perguntas cuja resposta soma linhas de muitas páginas, porque o número de fontes é fixo.
- Acima do limite de carga de uma coleção, as unidades dos últimos documentos enviados saem da busca sem aviso ao usuário.
- A avaliação é exploratória: acervos pequenos, só em português, gabaritos de um único anotador. A utilidade para usuários reais não foi avaliada.
Trabalhos futuros, em ordem de prioridade
- 1Tratar a vigência por unidade do documento: registrar o período de validade de cada artigo e comparar esses períodos em SQL.
- 2Avaliar o sistema com usuários reais, medindo o tempo até a resposta e se as fontes são de fato conferidas.
- 3Medir se o trecho exibido sustenta a frase da resposta.
- 4Ampliar os gabaritos, com um segundo anotador e documentos que o modelo não conhece.
- 5Comparar a expansão e a busca híbrida no próprio PostgreSQL.
Inteligência Documental com Proveniência Verificável sobre Modelo Relacional
O artigo completo, com 28 páginas, segue a Design Science Research. Código, gabaritos, resultados brutos e anexos estão no repositório.